
Шрифт:
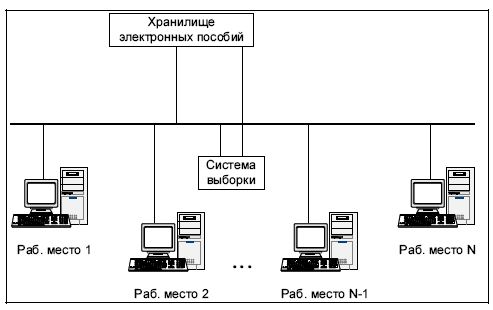
С чего же, по мнению автора, следует начать разработку такой системы? Видимо, с ее первого звена – электронной библиотеки отдельного вуза. Читальный зал такой библиотеки может представлять собой отдельный класс, компьютерные посадочные места в котором связаны с помощью локальной сети (рис. 10.6). К такой сети можно, строго говоря, подключить все или часть компьютерных классов, чтобы электронные пособия можно было использовать в процессе выполнения лабораторных работ, проведении лекционных и семинарских занятий. Уже сейчас в своей практике преподаватели СЗИП используют подобный порядок выполнения лабораторных работ. На файловом сервере устанавливается файл с подробным описанием лабораторной работы, которым могут пользоваться студенты, работающие за любым из 20 компьютеров, подключенных к этой локальной сети.
Второй этап создания электронной библиотеки отдельного вуза состоит в том, чтобы сделать ее доступной для студентов через глобальную сеть, т. е. организовать к ней удаленный доступ. Для этого организуется библиотечный Web-сервер, который взаимодействует с атрибутивной базой данных (см. также главу 7) электронных изданий на основе CGI-технологий [15, 20]. Вуз в данном случае может аккумулировать функции провайдера для предоставления возможности студентам работать с учебными изданиями в домашних условиях. Возможен вариант, когда на сайте ВУЗа специальный раздел предоставлен электронной библиотеке. Для работы с электронными учебниками может использоваться система паролей и взиматься небольшая абонементная плата (она может также включаться и в стоимость обучения).
Попытки электронной публикации баз данных часто терпят неудачу из-за столкновения с самыми разнообразными проблемами – техническими, организационными, финансовыми. Не последняя из них – задача создания надежного и эффективного интерфейса (front-end) для всех распространенных аппаратных и программных платформ и поддержание его совместимости с различными быстроразвивающимися операционными системами.
Наиболее эффективный способ использования баз данных в сети состоит в том, чтобы обеспечить для конечного пользователя возможность напрямую, в режиме реального времени выполнять запросы к базе данных через специальную "шлюзовую" программу. В настоящее время для этих целей используются, как правило, Web-сервер и SQL-сервер (сервер, использующий язык запросов SQL —Structured Query Language) баз данных, которые работают в высокопроизводительной среде UNIX. Web-сервер через браузер предоставляет конечному пользователю форму, считывает с нее заданные параметры поиска и передает их через стандартизированный интерфейс SQL-клиенту. Программа SQL-клиента преобразует полученные параметры в SQL-запрос, направляет этот запрос SQL-серверу, получает от него результаты, преобразует их в HTML-файл и передает обратно на Web-сервер. Затем Web-сервер пересылает HTML-файл с результатами выполненного запроса браузеру конечного пользователя (рис. 10.7).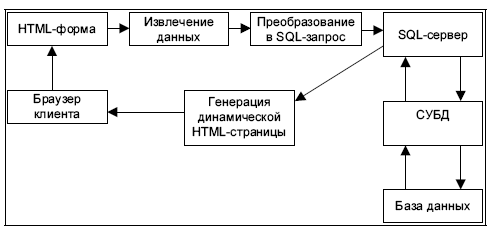
Таким образом, параметры поиска считываются из заполняемых пользователем HTML-форм; затем они преобразуются "шлюзовой" программой в SQL-запрос, направляемый SQL-серверу. Получив результаты произведенного поиска, SQL-сервер возвращает их обратно "шлюзовой" программе, которая формирует из них HTML-файл и передает его имя Web-серверу. Благодаря такой схеме программы просмотра могут служить независимыми от платформы внешними интерфейсами баз данных, предоставляя пользователям свежую информацию в виде динамически сгенерированной HTMLстраницы.
Главное в том, каким образом организовать стандартизованный интерфейс для взаимодействия между HTML-формой и SQL-клиентом. Существует несколько способов организации такого взаимодействия [32]:
✓ с применением технологии Java (применение Java-апплетов);
✓ на основе технологии IDC/HTX (Internet Database Connector/HTML Extension);
✓ на базе технологии ASP (Active Server Pages);
✓ с использованием интерфейса CGI (Common Gateway Interface) и CGIскриптов.
В узком смысле Java – это объектно-ориентированный язык, напоминающий C++, но более простой в изучении и приложении. В широком смысле Java – это технология программирования, ориентированная на интеграцию с Web-технологиями, т. е. на использование в сетевых средах. Поскольку для всех платформ существуют Web-навигаторы, Java-среда обязана быть в идеале полностью независимой от платформы. Для практического использования Java-технологий, помимо интеграции с Web-навигатором должна быть специфицирована виртуальная Java-машина (VJM), с помощью которой интерпретируется Java-апплет. В результате, при изменении аппаратной или программной платформы не потребуется вносить изменения в Java-апплеты. Апплеты (applets) представляют собой приложения на языке Java, включенные в текст HTML-документа с помощью тэга <APPLET>. Браузер, поддерживающий Java-апплеты, загружает с сервера HTML-документ и обнаруживает тэг <APPLET>. Далее браузер загружает с сервера так называемый файл класса, на который производится ссылка в тэге <APPLET>, и инициирует запуск самого апплета в Java-машине браузера. Затем апплет отображается в окне браузера или, при необходимости, создает свой собственный фрейм (см. также разд. 2.9). Каким образом с помощью Java-апплетов организовать доступ к базам данных? Для этой цели существует интерфейс JDBC (Java DataBase Connectivity) – связь Java-апплетов с базами данных. В свою очередь JDBC является составной частью Java API (Application Programming Interface) – интерфейса прикладного программирования, с помощью которого, используя готовые классы и приложения, можно написать мощный Java-апплет длиной всего в несколько строк. Интерфейс JDBC представляет собой набор объектов реляционного типа и методов взаимодействия с источниками данных. Java-апплеты используют объекты и методы из пакета java.sql.*, реализующего интерфейс JDBC. Однако для непосредственного доступа к источнику данных требуется специальный драйвер, ориентированный на конкретную систему управления базами данных (СУБД). Обычно это выполняется с помощью сопряжения JDBC – ODBC (Open DataBase Connectivity – связь с открытой базой данных). Программа сопряжения организует взаимодействие с любым ODBCдрайвером. Драйвер может общаться с сервером, на котором локализована удаленная база данных, используя протокол HTTP (HyperText Transfer Protocol) или RPC (Remote Procedure Call – удаленный вызов процедур). Интерфейс JDBC идентифицирует базу данных стандартным образом при помощи сетевого URL. Все сказанное иллюстрируется рис. 10.8.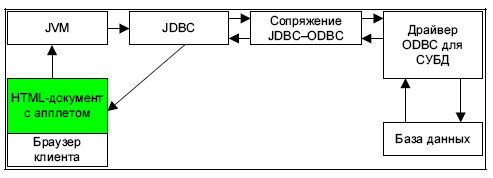
При всех достоинствах рассмотренной схемы взаимодействия она характеризуется двумя существенными недостатками. Первый из них определяется ограничениями, связанными с использованием языков для реализации интерфейсов, представленных на рис. 10.8. Другое ограничение определяется необходимостью активизации виртуальных Java-машин, иначе VJM (Virtual Java Machine) для запуска каждого Java-апплета. Каждая такая VJM потребляет значительные вычислительные ресурсы, существенно снижая скорость интерактивного взаимодействия. Эти два фактора делают практически невозможной работу такой структуры в реальном масштабе времени.
Технология IDC/HTX позволяет пользователю передавать параметры запроса к базе данных как часть сообщения Web-серверу. Сама аббревиатура IDC/HTX означает Internet Database Connector (связь через Интернет с базой данных) и HTml eXtension (расширение HTML). Такое сочетание означает, что для генерации динамической HTML-страницы необходимы 2 файла. В одном из них размещается запрос к базе данных на стандартном языке SQL, а в другом – шаблон, в соответствии с которым будут форматироваться в виде таблицы результаты выполнения запроса, т. е. пересылаемая пользователю динамическая HTML-страница. Запрос представляет собой исполняемый файл, который содержит описание действий, подлежащих выполнению на серверной стороне. Обычно, все такие файлы размещаются на серверной стороне в специальной папке с именем Scripts (сценарии). В этом же файле содержится имя файла шаблона и сведения об имени и пароле пользователя.
Технология IDC/HTX предусматривает следующую последовательность действий (рис. 10.9):
1. Активизацию пользователем в просматриваемом документе гиперссылки, указывающей на файл запроса.
2. Извлечение Web-сервером файла запроса из папки Scripts.
3. Получение из динамической библиотеки httpodbc.dll процедур, извлекающих из файла запроса имя источника внешних данных.
4. Активизацию и запуск в соответствии с источником данных нужного драйвера ODBC.
5. Соединение драйвера с базой данных и организация им выполнения запроса на языке SQL, а затем – возврат полученных результатов выбранной из библиотеки httpodbc.dll процедуре.
6. Извлечение процедурой библиотеки из файла запроса имени файла шаблона и формирование ею в соответствии с шаблоном HTML-файла.
7. Передачу этого файла Web-серверу и отсылку его пользователю.
Технология извлечения данных из удаленной БД, называемая ASP (Active Server Pages, или страницы активного сервера), отличается от IDC/HTX тем, что вместо простейшего алгоритма подстановки данных в поля шаблона используются специальные процедуры, содержащиеся в файле ASP и написанные на языке VBScript (возможно использование и JavaScript). VBScript представляет собой диалект языка Visual Basic, предназначенный для написания интерпретируемых процедур. Процедуры могут выполняться как на стороне пользователя, с помощью встроенного в браузер интерпретатора, так и на серверной стороне, где также должен быть интерпретатор, встроенный в Web-сервер или работающий совместно с ним. Файл ASP, хранимый в определенной папке на серверной стороне, содержит описание запроса к базе данных на языке SQL, описание шаблона для извлекаемых из базы данных и вложенные в это описание фрагменты на языке VBScript. Получив посредством гиперссылки запрос на ASP-файл, Web-сервер пересылает SQL-запрос СУБД, получает результат и выполняет над ним все процедуры VBScript, вложенные в текст шаблона. Таким образом, в этом случае (как и в предыдущем) никакой предварительной обработки запроса не производится, а все операции форматирования ответа должны быть заранее написаны в форме процедур VBScript. Технология разработана для работы преимущественно с СУБД фирмы Microsoft. Ее достоинства, возможно, проявятся в сложных информационных системах с архитектурой клиент-сервер при условии написания всех необходимых процедур на одном из языков программирования. В целом технологии IDC/HTX и ASP достаточно сложны в реализации и требуют использования определенных вычислительных ресурсов сервера.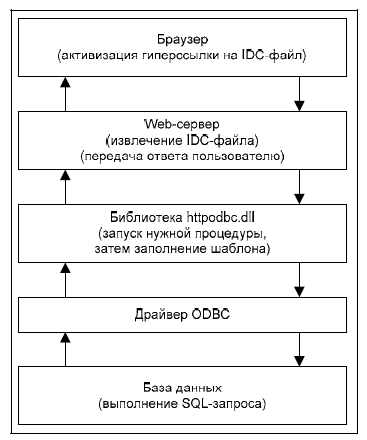
Аббревиатура CGI (Common Gateway Interface) означает ту часть Webсервера, которая может взаимодействовать с другими программами, выполняющимися на том же узле. CGI обеспечивает обмен данными между webсервером и программным модулем, который обрабатывает информацию, пришедшую Web-серверу от клиента. В этом смысле CGI является шлюзом для передачи клиентских данных программам их обработки. Таким образом, CGI – это программная среда, включающая в себя набор определенных переменных и протоколы взаимодействия с другими программами, функционирующими на Web-узле, например, с СУБД.
Одно из самых главных достоинств CGI – то, что этот интерфейс не накладывает никаких ограничений ни на язык программирования, на котором пишется программный модуль, выполняющийся на сервере, ни на операционную систему, под управлением которой работает Web-сервер. Так, модулем может быть как обычный исполняемый файл, написанный на языке программирования компилирующего типа, таком как C/C++ или Pascal, так и скрипт (script), написанный на языке командного интерпретатора UNIXсистем (например, bash или csh). CGI-технологии, как правило, используются в сочетании с наиболее распространенным Web-сервером Apache, обычно работающим под управлением операционной системы семейства UNIX (например, Linux). В качестве языка, на котором пишутся модули, исполняемые на сервере, и в особенности такие, которые организуют взаимодействие Web-сервера с какой-либо СУБД, большинство разработчиков использует язык Perl. В первую очередь хочется отметить, что использование языка Perl не снижает переносимость разработанного с использованием программного обеспечения интерфейса CGI. Так же, как интерфейс CGI поддерживают все "уважающие себя" Web-серверы, интерпретаторы языка Perl написаны для всех операционных систем и платформ. Очень важно также и то, что для языка Perl написан замечательный модуль CGI.pm (автор – Линкольн Штейн), с помощью которого довольно просто писать CGI-скрипты. Этот модуль предоставляет удобный интерфейс разработчику CGI-приложений, беря на себя всю черновую работу по реализации взаимодействия при помощи CGI-интерфейса. Остается добавить, что в последних версиях языка Perl этот модуль входит в стандартный комплект поставки.
Это наиболее существенные аргументы, так сказать, общего характера. Есть еще две серьезные причины отдать предпочтение CGI/Perl в случае написания приложения для Web-сервера, обеспечивающего именно взаимодействие с СУБД.
Первая из них – наличие модулей языка Perl для обеспечения взаимодействия со всеми распространенными СУБД: Ingres, Oracle, Informix, Interbase, Postgres, SyBase. Есть даже модуль для MS Excel. Нельзя не упомянуть и очень разумную внутреннюю организацию этих модулей, позволяющую максимально унифицировать интерфейс доступа к различным СУБД. Собственно, чтобы подсоединиться к какой-либо СУБД, вам надо установить два модуля: DBI.pm, обеспечивающий абстрактный интерфейс с СУБД, и собственно драйвер для взаимодействия с ней (например, DBD-Oracle.pm, если вы хотите работать с СУБД Oracle [38]). Преимущество такого подхода одно, но более чем значимое – универсальность и переносимость. Так, если вы писали в рамках стандарта языка SQL, не используя не стандартизованные расширения, а базу данных по неизвестным причинам решили перенести, скажем, под Informix, то в вашем CGI-скрипте, работающем с базой данных, достаточно будет поменять всего лишь одну строчку кода – подключение к драйверу взаимодействия с СУБД. В нашем случае (Informix вместо Oracle) надо заменить строчкуDBI->connect(\'dbi:Oracle:имябазы, …);
на
DBI->connect(\'dbi:Informix:имябазы, …);
Наконец, язык Perl обладает весьма гибкими и мощными средствами обработки текстовой информации, в том числе при помощи разветвленной системы регулярных выражений. Возможности языка Perl в обработке текстов, поиске и замене по шаблонам с помощью регулярных выражений позволяют проводить предварительную обработку данных практически любой сложности. А обработка данных перед занесением их в БД, их упорядочение и проверка целостности – важнейший этап взаимодействия пользователя с СУБД, и то, что эту задачу берет на себя CGI-скрипт, существенно улучшает и ускоряет работу СУБД и позволяет ей оптимально размещать и хранить данные. Серьезную помощь язык Perl может оказать и при реализации поиска в БД, позволяя данные, вводимые пользователем в удобном ему формате, преобразовывать в форму, удобную для "восприятия" СУБД, и тем самым предварительно оптимизируя поиск. Таким образом, язык Perl является едва ли не идеальным языком для реализации скриптов, т. е. "прослоек" между пользователем и большим программным продуктом с нетривиальным интерфейсом, коими являются практически все системы управления базами данных.
Однако, вернемся к основной теме этого раздела. Проектирование сетевой электронной библиотеки, как представляется автору, следует начать с создания информационного хранилища электронных изданий с качественной системой их поиска и извлечения. Функции хранения и извлечения учебных пособий, по нашему мнению, следует отделить от поисковой системы, т. е. структура хранилища должна быть двухуровневой (рис. 10.10):
✓ На нижнем уровне осуществляется хранение учебных пособий в электронном виде. Структурно хранение пособий осуществляется в виде гипертекстовой базы данных или же в форме иерархической файловой системы. Второй вариант автору представляется предпочтительным по причинам, которые будут изложены далее.
✓ На верхнем уровне проектируется атрибутивная база данных, в качестве атрибутов в которой используются фамилии преподавателей, названия учебных курсов, названия и шифры специальностей, конкретный вид учебного пособия, год издания, а также год и месяц его обновления и пр. Дополнительно к этому организуется хранение ключевых слов, характеризующих каждое пособие.
Методика и технология выбора (извлечения) ключевых слов и организация поиска по ключевым словам составляет то ноу-хау, которое отличает предложенный автором вариант организации электронной библиотеки. Результат поиска в этой базе данных представляется в виде списка пособий с миниатюрами (в простейшем случае они представляют собой уменьшенную фотографию электронной обложки или титула издания). Из этого списка читатель выбирает нужное издание и, при наличии соответствующих прав доступа, издание извлекается с нижнего уровня и передается на рабочее место пользователя.
В предлагаемой поисковой системе в скрытой форме используется физический адрес пособия (URL) на нижнем уровне. Это может быть и сетевой адрес, в том числе не только в локальной сети, но и адрес в сети Интернет. Таким образом, предлагаемая структура в дальнейшем органично встраивается в интегрированную распределенную систему хранения и поиска учебных пособий, представленных в электронной форме. Третий этап работы состоит в разработке и реализации такой структуры.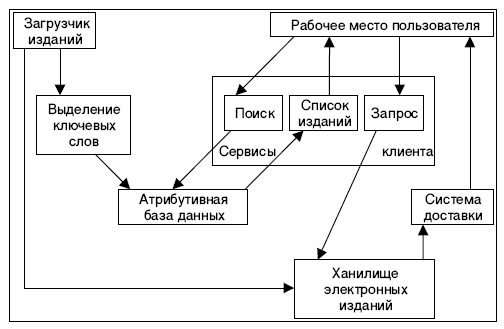
Преимущества такой информационной структуры состоят также и в том, что при ее создании не потребуется связывать или объединять хранилища самих электронных изданий. Для создания сетевой библиотеки потребуется только одно – каждое электронное учебное издание должно иметь точный адрес. В этом случае, выбрав как результат поиска требуемое пособие и имея права доступа к самим изданиям, любой студент сможет получить такое пособие, независимо от того, на сервере какого учебного заведения оно локализовано. Таким же образом, в принципе, могут быть объединены и другие библиотеки нашей страны, включая самые крупные из них.
Основные затраты при создании интегрированной библиотеки электронных учебных изданий будут связаны с проектированием и поддержанием сервера, на котором будет локализована общая (интегрированная) атрибутивная база данных, а также с разработкой структуры и программного обеспечения самой этой базы данных. Помимо собственно атрибутов в базе данных целесообразно хранить различную сопутствующую информацию. В ее состав, по мнению автора, наряду с миниатюрами пособий следует обязательно включить их аннотации и, может быть, оглавления (содержание), пусть даже в сокращенной форме. Хотя объем атрибутивной базы данных в этом случае увеличится, зато выбор пособия будет более осознанным и снизится вероятность отказа от полученной книги после поверхностного знакомства с ее содержанием.
Интеграция на уровне атрибутивных данных приведет к резкому сокращению информационного объема общей или коллективной базы данных. Такой результат понятен – объем атрибутивной информации на 2 порядка меньше, чем самих электронных пособий. Кроме того, каждое учебное заведение будет по-прежнему полностью контролировать доступ к книгам своей внутренней электронной библиотеки. В его интеграционные функции будет входить лишь передача атрибутов каждого вновь подготовленного издания и его URL в сетевую атрибутивную базу данных. Схема информационных потоков в такой системе показана на рис. 10.11.
Выделение этих атрибутов, как уже было указано в главе 8, является достаточно сложной и важной задачей, так как именно их качественный отбор позволит успешно и быстро найти нужное пособие. Методика и программные средства для реализации извлечения атрибутов достаточно подробно изложена в главе 8 и работе [12].
Несколько слов относительно формата самих электронных пособий. Накопленный автором в течении последних 3 лет работы опыт работы с электронными пособиями при проведении лекций и лабораторных занятий показывает, что вкусы студентов могут значительно разниться в зависимости от их уровня подготовки и навыков, привитых им еще в средней школе, а также ряда других причин. В качестве базового варианта разумно остановить выбор на формате HTML. По мнению автора, рисунки лучше не включать в сам текст издания, а вызывать с помощью гиперссылок в отдельных окнах.
Для просмотра пособия в таком формате можно использовать любой стандартный браузер, например, MS Internet Explorer.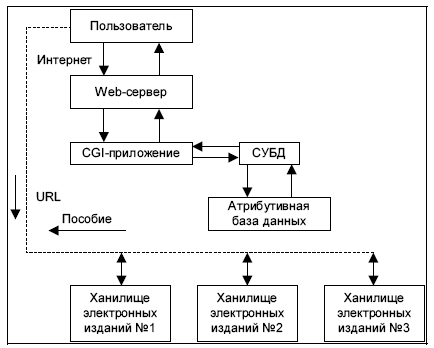
Для тех студентов, которым привычнее работать с печатным текстом, можно предоставить электронное пособие в формате PDF, естественно, также гипертекстовое. Просмотр пособий, представленных в этом формате, осуществляется посредством пакета Adobe Acrobat Reader, также достаточно широко распространенного в нашей стране. Кстати, оба эти формата обеспечивают фреймовую структуру представления на экране монитора.
Автору представляется целесообразным выбор 2 или 3 фреймов. Один из них, базовый, в котором отображается основное содержание пособия, разбитое на нужное число фрагментов (главы, параграфы). Другой – навигационный, в нем должна быть показана рубрикация учебника, что позволит ориентироваться в учебном материале и легко переходить от одного раздела к другому. В третьем фрейме целесообразно разместить вспомогательную информацию: электронный адрес автора пособия, ссылки на другие пособия, адрес сайта высшего учебного заведения и пр. [13].
Кстати, само электронное пособие также может быть представлено в виде сайта, на лицевой странице которого размещается оглавление. Отдельные позиции оглавления оформляются как указатели гиперссылок, которые ведут к Web-страницам с отдельными главами, параграфами и подпараграфами. Подпараграфы состоят из отдельных экранов (Web-страниц), содержащих текстовую, иллюстрационную и другую информацию. В этом случае не требуется применение фреймовой структуры, так как с любой страницы посредством ссылок студент сможет возвратиться на лицевую или главную, которая обеспечивает глобальную навигацию в пределах всего учебного пособия.
Простейшим вариантом учебного пособия автору представляется документ, оформленный в гипертекстовом формате DOC редакторов Word 97– Word 2002. Основные части пособия (главы, параграфы и пр.) целесообразно сделать чисто текстовыми, содержащими ссылки на рисунки. Рисунки выводятся в отдельных окнах (с помощью одной из многочисленных программ, предназначенных для просмотра графики – viewers) в каком-либо одном из сжатых графических форматов, например, TIFF, JPEG или GIF. Первые два во многих случаях предпочтительны, так как позволяют выводить полноцветное изображение, в то время как GIF работает только с индексированными цветами, число которых не превышает 256.
Помимо графики в пособии могут использоваться анимационные изображения, цифровое аудио и видео. Анимация может представляться в самых экономичных форматах GIF и Flash, а цифровое аудио и видео – в форматах AVI и WAV. Все перечисленные форматы поддерживаются стандартными браузерами, программой Acrobat Reader и даже редакторами Word 2000 и Word 2002. В будущем, вероятнее всего, все большее количество мультимедийных фрагментов будет использоваться в пределах каждого учебного пособия. С их помощью можно наглядно представлять любые информационные и технологические процессы.
Отметим, что для мультимедийных электронных изданий, век массового использования в повседневной практике которых уже не за горами, иерархическая файловая структура представляет наиболее разумный способ хранения. Каждое такое пособие следует хранить в отдельной папке, в которой в виде специального гипертекстового файла содержится базовый текст. Здесь же следует разместить папки с рисунками, сгруппированными по главам, а также аудио– и видеофайлы. Если число последних велико, их также можно сгруппировать по главам. Папка с изданием рассматривается как единое целое и перемещается только целиком. В этом случае не возникает никаких проблем с гиперссылками, реализующими относительные пути к объекту ссылки.
Вероятно, постепенно в локальных сетях ВУЗов все активнее будут использоваться корпоративные интрасети, основным средством просмотра в которых служит браузер. С этой точки зрения, следует преимущественно ориентироваться на формат HTML, который, к тому же, является и наиболее экономичным. А это немаловажный фактор при пересылке данных по сетям.